Economie du document (Bloc-notes de Jean-Michel Salaün)

Repérage de données sur l'économie des documents dans un environnement numérique

Aller au contenu | Aller au menu | Aller à la recherche

vendredi 18 février 2011

Le côté obscur des requêtes sur les moteurs

Paulette Bernhard a attiré mon attention sur un récent article du NYT, merci à elle.

David Segal, “Search Optimization and Its Dirty Little Secrets,” The New York Times, Février 12, 2011, rub. Business Day, ici.

L'article conte l'histoire d'une manipulation pas très propre des résultats de recherche de Google à des fins commerciales. La technique est connue et il existe même des professionnels spécialisés dans le domaine, les référenceurs ou SEO (pour Search engine optimization) qui jouent au chat et à la souris avec les moteurs pour placer au mieux leurs sites clients dans les pages de résultats de recherche. Mais l'ampleur de la manipulation, la méthode employée et la réaction de Google méritent en effet qu'on s'arrête à cette histoire.

Pendant quelques mois et donc pendant la période des fêtes, lorsque l'on tapait dresses, bedding ou area rugs (carpettes) ou encore “skinny jeans”, “home decor”, “comforter sets” (couettes),“furniture” et des douzaine d'autres mots ou phrases, y compris des marques comme Samsonite le même site sortait numero 1 ou dans les tous premiers : JC Penney une chaîne de magasins pour la famille implantés partout aux US, 1100 magasins, 17,8 Mds $ de CA.

Il y a en moyenne pour les US 11,1 millions de requêtes mensuelles sur dresses, si l'on considère que 34% cliquent sur la première réponse (ici), cela signifie que JC Penney a attiré ainsi 3,8 millions de visiteurs sur son site chaque mois, rien qu'avec ce seul mot.

Bien entendu, ces résultats sont la conséquence de techniques d'optimisation du PageRank du site, qui, si elles ne sont pas illégales, relèvent d'une manipulation peu conforme à la netétiquette. « Quelqu'un » a tout simplement payé pour que des milliers de sites pointent vers JC Penney et augmentent ainsi ses chances d'être bien classé par le moteur. L'enquêteur NYT a repéré, par exemple, 2015 pages de sites les plus divers contenant des liens sur “casual dresses” , “evening dresses” “little black dress” ou “cocktail dress” dirigeant vers le site JC Penney. Beaucoup de ces sites ne sont même pas actifs, juste des réservoirs de liens. Mais l'opération est gagnant-gagnant. Le journaliste a pu retrouver un responsable de site qui lui a indiqué qu'il gagne environ 150$ par mois, il ajoute : Je n'ai rien à faire, les annonces sont juste là et si quelqu'un clique dessus, je fais de l'argent. Il héberge 403 liens, tous placés par une régie (TNX).

Le plus surprenant, mais bien intéressant, est qu'il semble que Google ne se soit aperçu de rien avant d'être alerté par le NYT. Ils ont alors rétrogradé JC Penney à la main (!). Contrairement à ce qui s'était passé pour BMW, aucune autre sanction ne parait envisagée. Mais JP Penney fait aussi partie des meilleurs clients de Google avec un budget publicitaire mensuel de 2,46 million de $.

Il y a ainsi un côté obscur de la recherche sur le web où des « chapeaux noirs » (black hats) organisent en sous-main un commerce lucratif de liens. On n'est pas loin de pratiques mafieuses. Cet article permet de lever un coin du voile de cette économie souterraine proche de celle des spammeurs. Il montre aussi qu'il faudrait un jour (bientôt) introduire une déontologie pour séparer les intérêts commerciaux des intérêts informationnels de ce nouveau média.

Pour une bonne analyse du phénomène et en particulier les pratiques des chapeaux blancs, gris et noirs et les difficultés de régulation voir :

Trusting (and Verifying) Online Intermediaries' Policing, Frank Pasquale ici

Actu du 21 fév 2011

Voir aussi sur le sujet les interrogations d'Olivier Andrieu, une référence pour les SEO français, Abondance (ici), lire aussi les commentaires.

Actu du 27 févr 2011

Décidément le pb semble ardu. Google annonce un grand ménage et un changement dans son algorithme ici

Actu du 29 fev 2011

Ça n'a pas traîné ici

Ou le lendemain cet article de Libé qui fait le point (là)

Actu du 13 mars 2011

Après l'UE, la commission antitrust du Congrès américain a mis la question à son ordre du jour. Communiqué ici.

Partie sur Google :

Competition in Online Markets/Internet Search Issues

Access to the wealth of information and e-commerce on the Internet is essential for consumers and business alike. As the Internet continues to grow in importance to the national economy, businesses and consumers, the Subcommittee will strive to ensure that this sector remains competitive, that Internet search is fair to its users and customers, advertisers have sufficient choices, and that consumers’ privacy is guarded. In recent years, the dominance over Internet search of the world’s largest search engine, Google, has increased and Google has increasingly sought to acquire e-commerce sites in myriad businesses. In this regard, we will closely examine allegations raised by e-commerce websites that compete with Google that they are being treated unfairly in search ranking, and in their ability to purchase search advertising. We also will continue to closely examine the impact of further acquisitions in this sector.
lundi 14 février 2011

L'impact des bibliothèques en temps de crise et de numérique

OCLC a publié un nouveau rapport sur la perception des bibliothèques qui actualise les résultats de 2005 (ici). Il est bourré d'informations, de chiffres et graphiques sur les avis et attitudes des Américains face à leur bibliothèque. La partie la plus intéressante à mon avis est l'analyse fine des perceptions des populations les plus touchées par la crise économique qui baissent leurs dépenses culturelles, mais augmentent leur fréquentation de la bibliothèque, à la fois pour leurs loisirs et pour les informations sociales qui y sont accessibles, notamment par l'accès libre à l'internet.

Voici quelques uns des résultats les plus significatifs :

  • La principale raison de l'augmentation de l'usage de la bibliothèque en 2010 est de faire des économies. Les dépenses de livres, CDs et DVDs ont baissé pour 76% de ceux pour lesquels la récession a eu un impact négatif sur le travail. La bibliothèque comble le fossé. 1/3 de cette population utilise plus la bibliothèque et 75% de ceux-là disent qu'ils empruntent maintenant des livres ou des CD plutôt que d'en acheter.
  • Les moteurs tiennent toujours le haut du pavé pour la recherche d'information. Mais les taux de satisfaction baissent pour tous les services de recherche en ligne. Le succès des moteurs ne tient pas seulement à leur rapidité mais aussi à leur fiabilité à fournir une information utile, crédible et gratuite.
  • Les réseaux sociaux concernent tous les âges.
  • Rester connecté est une priorité. Les consommateurs paient pour cela.
  • Les consommateurs d'information ont confiance dans leur capacité à trouver l'information. S'ils doutent, ils font d'autres recherches.
  • l'utilisation des services de questions à un expert a fort augmenté de 15% en 2005 à 43% en 2010. Mais les services de questions à un bibliothécaire (ask-a-librarian) n'ont pas décollé.
  • Le « livre » est plus que jamais l'image de marque de la bibliothèque. 69% le mettait en premier en 2005, 75% en 2010.
  • Pour les plus jeunes (14-17) la bibliothèque est d'abord un lieu pour lire, pour tous les autres c'est d'abord un lieu pour avoir des livres, de la vidéo et de la musique.
  • La préoccupation principale en 2005 était que les bibliothèques ajoutent du contenu, en 2010, c'est : ouvrez plus longtemps.
  • Moins de personnes recherchent de l'aide (68% en 2005, 51% en 2010).
  • La bibliothèque en ligne ne s'est pas substituée à la bibliothèque physique. Les usages de la bibliothèques ont fortement augmenté en 2010, pas les consultations des sites web de bibliothèques.
  • Seuls 17% des usagers pensent que les bibliothécaires font de la publicité pour leurs services.
  • Les usagers sont conscient de la valeur ajoutée par les bibliothécaires.

De quoi méditer, mais pas vraiment de quoi être pessimiste.

vendredi 11 février 2011

Paradoxes de la mesure de l'information

Le numéro de Science qui vient de sortir (ici) est entièrement consacré aux questions posées par l'explosion quantitative des flux de données pour la recherche. Les articles concernent autant les transformations sur des disciplines (climat, écologie, neuroscience, santé, sciences sociales, biologie, génomique, physique des particules, astrophysique..) que des problématiques transversales (visualisation 3D, théorisation des capteurs et du signal, métaconnaissances, mesure de l'information). Un numéro très riche donc, essentiel témoignant d'un tournant fondamental dans la construction et l'exposition de nos savoirs.

Avant de présenter dans un futur billet un article particulièrement stimulant sur le traitement des métaconnaissances dans les articles scientifiques (ici), je voudrais alerter sur les interprétations trop rapides que l'on peut faire d'un autre.

Martin Hilbert et Priscilla Lopez, “The World's Technological Capacity to Store, Communicate, and Compute Information,” Science Express (Février 11, 2011): 692-693. (là)

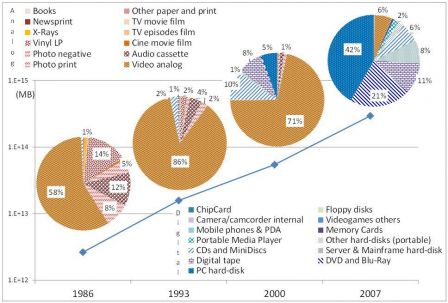
Celui-ci reprend un leitmotiv des sciences de l'information : la mesure de l'explosion de l'information. Sans surprise car il fait image et paraît illustrer ou même démontrer scientifiquement d'une situation que chacun pressent, il a déjà été largement signalé et commenté par la presse (par ex ici, là, là, ou pour être en résonance avec mon sujet là). Il tente, en effet, de mesurer l'information enregistrée, l'information communiquée et l'activité de calcul. Ici je ne reprendrai que le raisonnement concernant l'information enregistrée.

L'ensemble peut-être résumé par cette diapo et trois citations :

Hilbert-Lopez-Science-11-02-2011.jpg

Extraits (trad JMS) :

Le montant total d'information s'est accru de 2,6 exaoctets (10 puissance 20) compressés de façon optimale en 1986 à 15,6 en 1993, plus de 54,5 en 2000, à 295 en 2007. C'est l'équivalent de pas moins d'un cédérom de 730 Mo par personne en 1986 (539 Mo), en gros 4 cédéroms par personne en 1993, 12 l'année 2000 et presque 61 en 2007. (..)

En 1986, les disques vinyles comptaient encore pour une part significative (14%), tout comme les cassettes audio analogiques (12%) et la photo (5 et 8%). Ce n'est qu'à partir de 2000 que le numérique a commencé à compter pour notre mémoire technologique, représentant 25% du total. Les disques durs se taillent la part du lion en 2007 (52%), les disques optiques font plus du quart (28%) et les bandes numériques environ 11%. Les solutions de stockage sur papier prennent une part décroissante (0,33% en 1986 et 0,007% en 2007), bien que leur capacité n'a pas cessé d'augmenter en terme absolu de 8,7 à 19,4 Petaoctets compressés de façon optimale.

Si leur démonstration me parait bien illustrer la rapidité de la bascule vers le numérique, elle pose une question préalable quant à l'étalon de mesure et donc son interprétation. Voici donc les éléments à ce sujet, qu'on ne retrouve malheureusement pas dans les comte-rendus de presse :

L'information dans sa conception théorique est l'opposée de l'incertitude. Shannon a défini un octet comme la quantité d'information qui réduisait l'incertitude de moitié (dans un espace de probabilité comme des lettres de l'alphabet ou des pixels sur une échelle de couleur). Cette définition est indépendante de la tâche spécifique ou du contenu. Après normalisation en octets compressés nous pouvons dire par exemple « une image de journal carrée de 6cm de côté est équivalente à 1.000 mots », parce que les deux demandent le même nombre moyen de décisions binaires oui/non pour résoudre le même montant d'incertitude.

Cet étalon est classique, c'est celui de la théorie générale de l'information de Shannon (wkp). Il a déjà été beaucoup discuté, car il fait référence à concept d'information particulier, qui sert à l'optimisation du signal. Certains, notamment Weaver par la cybernétique, ont voulu l'étendre à toute situation de communication, non sans ambiguïtés (wkp). Mais s'il est dans cet article cohérent de l'employer pour mesurer les capacités de stockage informatique, cela devient plus problématique lorsque que l'on déborde sur d'autres domaines et la polysémie du mot information nous fait vite déraper. Les auteurs de l'article ne manquent pas de tomber dans ce travers.

Même en restant dans la perspective mécaniste qui est la leur, deux objections viennent rapidement à l'esprit :

  • Mesurer l'information contenue sur un support analogique avec un étalon numérique préjuge déjà que l'ensemble de celle-ci sera converti en numérique. Supposons un instant que nous fassions l'inverse, mesurer l'information numérique par un étalon papier, c'est à dire tout simplement mesurer la surface de la sortie imprimante ramenée à un format moyen (comme les auteurs ont pris une compression optimale pour le signal). Nous aurions alors approximativement le résultat suivant pour le même exemple : « une image de journal carrée de 6cm de côté est équivalente à 76 mots » avec une mesure indépendante de la tâche spécifique ou du contenu. Le rapport quantitatif entre l'image et l'écrit est totalement inversé.
  • Plus problématique encore, les auteurs concluent leur article par une comparaison entre la capacité humaine à traiter l'information par les neurones et la capacité des ordinateurs. Mais nous savons aujourd'hui la captation et le traitement du signal par les sens et un cerveau humain pour la lecture par exemple (wkp), n'a pas grand chose à voir avec celle d'un ordinateur. Et que penser de l'image vidéo à 25 images par seconde, traitée à l'évidence complètement différemment par l'œil humain, la persistance rétinienne et notre cerveau, et par un signal numérique et un ordinateur analysant séparément chaque image ?

Dès lors que mesurent vraiment les auteurs de l'article ?

Actu du 15 février

Voilà un bel exemple de ce que devient l'étude revisitée par la presse, et réduite à un schéma sans référence à la pertinence de la mesure ici le Washington Post

jeudi 03 février 2011

Facebook, une équation à plusieurs inconnues

Décidément Facebook est bien un objet étrange. Comme pour Wikipédia nous ne disposons pas vraiment d'outil ou de concept adhoc, et il résiste à l'analyse.

Et encore l'économie de Wikipédia n'est pas vraiment mystérieuse (ici). J'ai déjà eu l'occasion de montrer que celle de Facebook, tout comme Twitter d'ailleurs, reposait sur les bases très fragiles de la spéculation (ici, là ou encore là). Le tout peut-être résumé en une image.

CA-2009-Apple-Google-Facebook.png

La spéculation repose sur les promesses de l'implantation du réseau. De ce point de vue, le succès est, en effet, éclatant. On peut le mesurer à la fois en terme de trafic et de géographie. Thierry Joliveau a proposé une très intéressante critique (ici) de la cartographie des «amis» réalisée par la firme (là) de façon quelque peu complaisante. Il présente ainsi la carte réinterprêtée.

Facebook-Joliveau.jpg

Il la compare à la démographie, à la répartition de l'électricité, des connexions ou encore des réseaux concurrents et en conclut :

Cette petite analyse n’a donc pas apporté de vues révolutionnaires sur la présence Facebook. Elle illustre en passant comment combiner, croiser et recouper les données cartographiques, que l’on peut trouver sur le Net. Elle rappelle cependant que Facebook ne concerne encore qu’un minorité de la population de la planète, celle qui a accès à un ordinateur. Elle montre aussi que ces outils magiques nécessitent une infrastructure technique et un environnement économique capable de les supporter et dont l’efficacité varie selon les pays. Ceci dit, la domination de Facebook sur la grande majorité des zones à accès Internet hyperdense est saisissante. Le Japon en est un contre-exemple très spécifique. On note aussi des variations très fortes d’un pays à l’autre qui montrent que contrairement à ce qu’affirme la vulgate Facebook à propos de la connexion généralisée, les frontières politiques, culturelles et sociales demeurent fortes.

Il est peu probable que le hiatus entre l'économique et l'usage qui se creuse perdure longtemps. Les spéculateurs imaginent ou laissent croire qu'un marché va s'ouvrir très vite. Le pari est encore très incertain pour ne pas dire aujourd'hui improbable.

Dans le même temps ces outils, devenant de plus en plus populaires, apparaissent à tort ou à raison comme indispensables. Un courant, relayé aujourd'hui par des politiques, les assimilent à des droits fondamentaux. Les mouvements récents au Maghreb ajoutent de la crédibilité à cet argumentaire, non sans évidemment d'arrière-pensées géopolitiques.

Mais le discours politique qui les rapproche des droits de l'homme devrait alors avoir sa traduction économique. Il suppose que, s'ils ne peuvent se financer de façon autonome, ils soient soutenus sur fonds publics, comme l'est la presse ou la radio-télévision. Nous en sommes très loin, il faudrait d'abord un arrêt de la spéculation. Et de toutes façons, les responsables de Facebook ne semblent pas, non plus, avoir pris la mesure de leurs responsabilités politiques ou, autre hypothèse, l'ont prise mais de façon bien inquiétante (là).

En complément lire : What is Facebook really ? là

Actu du 7 février 2011

Une autre façon de mesurer lucidement l'activité et les investissements de Facebook est de suivre ses investissements dans les data-centers voir ici.

Actu du 10 février 2011

Facebook serait en train de prendre une place dominante sur le marché du display (affichage numérique) d'après MC Beuth ici relisant le dernier rapport de Comscore (là)

Actu du 13 février 2011

Un avis différent de F. Filloux ici, mais les chiffres sont fragiles.

Actu du 24 février 2011

Le gendarme de la bourse US s'en mêle ici

samedi 29 janvier 2011

Apple et le marché du contenu

En lisant un intéressant billet de H. Guillaud qui s'interroge sur la stratégie de Amazon (ici), je me suis aperçu que je n'avais pas encore publié ce graphique de l'évolution du chiffre d'affaires de son concurrent sur les tablettes : Apple, réalisé à partir de la compilation de ses bilans financiers.

CA-Apple.png

On y voit clairement que le métier de Apple est la vente de contenant, de machine et OS, et non du contenu, de fichiers et Apps. Le contenu n'est là que pour stimuler le marché principal, même si sa stratégie a un fort impact sur ce dernier. En cela, Apple ressemble à Google pour qui le contenu sert à alimenter le marché publicitaire (ici).

Ainsi il me parait difficile de comparer iTune et les Kindle Singles comme le propose O. Ertzscheid (là).

Actu du 3 mars 2011

Intéressante comparaison du WSJ entre la patience d'un S Jobs et la précipitation d'un Messier pour le lancement d'un nouveau produit ici.

- page 31 de 144 -